Projets data analysis et statistiques
Exploration, statistiques descriptives, tests d'hypothèses, A/B testing et analyse textuelle
A/B testing : optimisation d'une landing page
Problématique marketing : Quelle version d'une page d'atterrissage (ancienne ou nouvelle) convertit le mieux les visiteurs ?
Objectif : Comparer deux versions lors d'une expérimentation contrôlée et décider s'il faut déployer la nouvelle page.
Méthode
- Nettoyage de 294 478 lignes de trafic web : 3 893 lignes incohérentes retirées (groupe ne correspondant pas à la page affichée), soit 290 585 utilisateurs conservés.
- Calcul du taux de conversion de chaque groupe.
- Z-test des proportions pour vérifier si l'écart est statistiquement significatif.
Résultats et recommandation
- Ancienne page : 12,04 % de conversion (17 489 sur 145 274).
- Nouvelle page : 11,88 % de conversion (17 264 sur 145 311).
- Z-test : z = 1,31 et p-value = 0,1897, supérieure au seuil de 0,05. La différence n'est pas significative.
- Recommandation : ne pas déployer la nouvelle page et tester une autre variante.
Rétention et cohortes d'une application mobile (données simulées)
Problématique métier : Une application mobile perd la majorité de ses utilisateurs peu après l'installation. Comment mesurer cette perte, la suivre par cohorte et repérer les profils d'utilisateurs ?
Objectif : Construire un générateur de données d'événements, puis appliquer une analyse de cohortes, une courbe de survie de Kaplan-Meier et une segmentation comportementale. Précision : les données sont entièrement simulées, ce projet démontre une méthode et non un résultat métier.
Méthode
- Générateur Python : 100 000 utilisateurs, 4 sources d'acquisition (Organic, Paid Ads, Social Media, Referral) et installations réparties sur 90 jours.
- 272 672 événements simulés (installations, sessions et achats) selon 3 profils de rétention.
- Matrice de rétention par cohorte d'installation, courbe de survie globale (Kaplan-Meier) et segmentation comportementale.
Résultats et limites
- 3 segments : utilisateurs inactifs après l'installation (60 %), occasionnels (27 %) et intensifs (13 %).
- La répartition des segments est quasi identique selon la source (59 à 60 % d'inactifs). C'est attendu : la source est tirée au hasard dans le simulateur.
- Sur des données réelles, cette comparaison orienterait le budget d'acquisition.
Facteurs influençant les performances commerciales
Problématique métier : Une entreprise souhaite comprendre les liens entre ses catégories de produits, ses régions et sa rentabilité pour optimiser sa stratégie commerciale.
Objectif : Analyser les relations entre variables (quali-quali, quali-quanti, quanti-quanti) pour repérer les leviers de performance.
Méthode
- Analyse de 9 994 lignes de commandes.
- Nuage de points ventes / profit par catégorie et heatmap des corrélations.
- Profit moyen par région et tableau croisé région × catégorie.
Résultats et recommandation
- Les fournitures de bureau représentent le plus gros volume de commandes dans les 4 régions.
- Ouest : premier volume (3 203 commandes) et profit moyen le plus élevé (33,85 $ par ligne).
- Sud : volume le plus faible (1 620 commandes). Centre : rentabilité la plus faible (17,09 $ par ligne).
- Recommandation : relancer l'acquisition dans le Sud et analyser la faible rentabilité du Centre.
Engagement des employés et détection d'outliers
Problématique métier : Une entreprise souhaite repérer les salariés dont le niveau d'engagement est anormalement bas afin d'agir avant qu'ils ne décrochent.
Objectif : Étudier la distribution des scores d'engagement et isoler les valeurs aberrantes.
Méthode
- Base de 311 employés et score d'engagement issu d'une enquête (sur 5).
- Statistiques descriptives : moyenne 4,11, médiane 4,28, écart-type 0,79.
- Histogramme, boxplot et règle de l'écart interquartile (1,5 × IQR) pour détecter les outliers.
Résultats et recommandation
- La moitié des employés a un score entre 3,69 et 4,70.
- 9 outliers détectés (environ 3 % des employés), tous en dessous de la limite basse de 2,175, avec un minimum à 1,12.
- Ces 9 profils ont aussi une performance faible : 6 sont en plan d'amélioration (PIP) et 3 sont notés « Needs Improvement ».
- Recommandation : croiser ces profils avec leur département et leur manager pour savoir si le désengagement est isolé ou concentré.
Tests statistiques et écarts entre départements
Problématique métier : Les écarts de satisfaction et de performance observés entre départements sont-ils réels ou dus au hasard ?
Objectif : Valider ou écarter les différences observées avec des tests statistiques adaptés.
Tests réalisés
- Normalité : Shapiro-Wilk. La performance ne suit pas une loi normale, d'où le choix d'un test non paramétrique.
- Satisfaction × département : khi-deux et V de Cramér.
- Performance par département : test de Levene, puis Kruskal-Wallis.
- Heures hebdomadaires × performance : corrélation de Spearman.
Résultats et recommandation
- Base de 100 000 employés.
- Satisfaction et département : p = 0,475 et V de Cramér = 0,063 (lien négligeable).
- Performance entre départements : Kruskal-Wallis p = 0,468, aucun écart significatif.
- Heures travaillées et performance : Spearman ρ = −0,006 et p = 0,075, aucune relation significative.
- Recommandation : le département n'explique ni la satisfaction ni la performance. Chercher d'autres facteurs (poste, manager, ancienneté).
Profil des vins et réduction de dimensionnalité (ACP)
Problématique métier : Identifier ce qui différencie les vins pour personnaliser les recommandations clients.
Objectif : Résumer 11 variables physico-chimiques en quelques axes lisibles et visualiser la structure des données.
Méthode
- 1 599 vins rouges décrits par 11 variables.
- Standardisation des données, puis ACP.
- Visualisations 2D et 3D colorées par note de qualité, et heatmap des poids de chaque variable.
Résultats et recommandation
- 2 axes conservent 45,7 % de l'information, 3 axes en conservent 59,8 %.
- Axe 1 : l'acidité (acidité fixe, acide citrique, pH), qui oppose des vins vifs et structurés à des vins plus ronds.
- Axe 2 : le dioxyde de soufre (sulfites).
- Recommandation : segmenter les clients selon leur goût pour l'acidité et repérer les vins pauvres en sulfites pour la clientèle « nature ».
Analyse textuelle et NLP (corpus médias sur le Soudan)
Problématique : Quels thèmes structurent le discours de la presse sur la guerre au Soudan ?
Objectif : Extraire automatiquement les mots dominants, les cooccurrences et les thématiques d'un corpus de presse avec le logiciel Iramuteq.
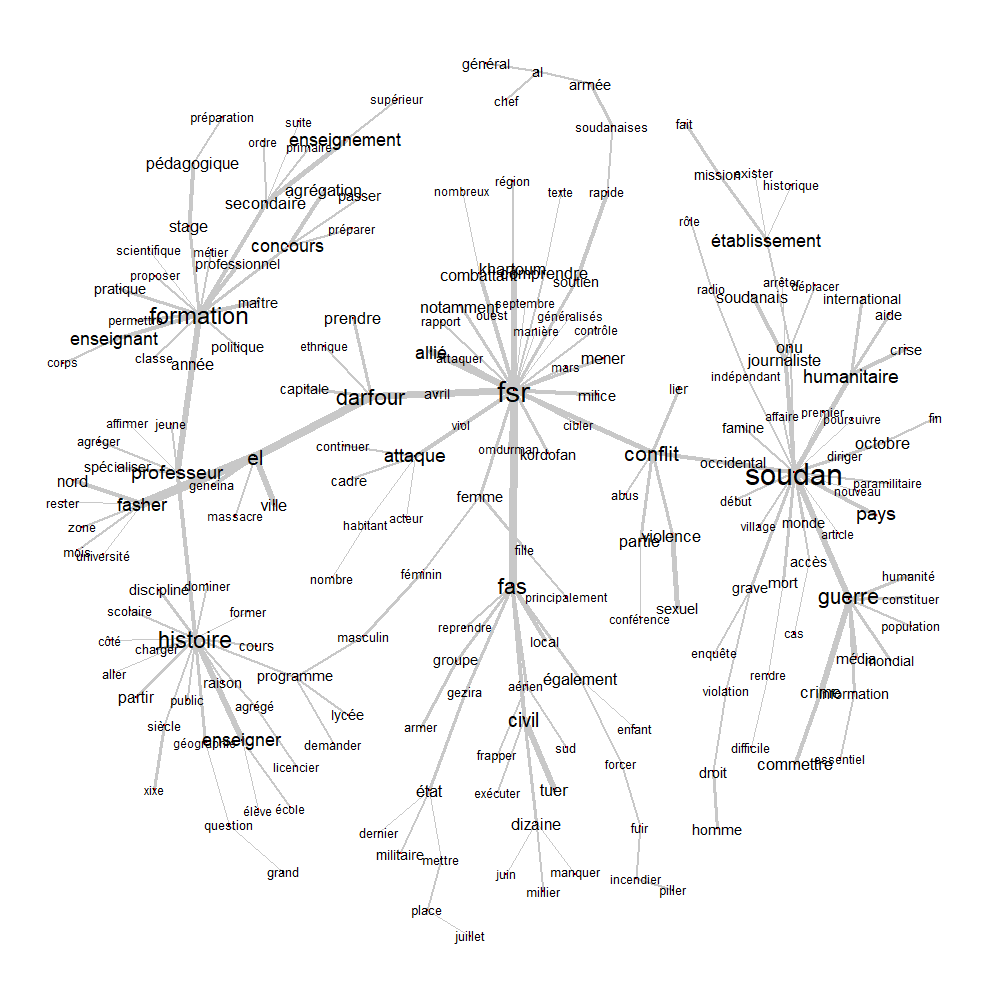
Graphique de similitude
- Les mots les plus liés forment des groupes distincts.
- Crise humanitaire : Soudan, humanitaire, famine, ONU, aide, journaliste.
- Conflit armé : FSR, Darfour, Khartoum, milice, attaque, combattants, violences sexuelles.
- Guerre et crimes : guerre, crime, violation, droit, civil.
Nuage de mots
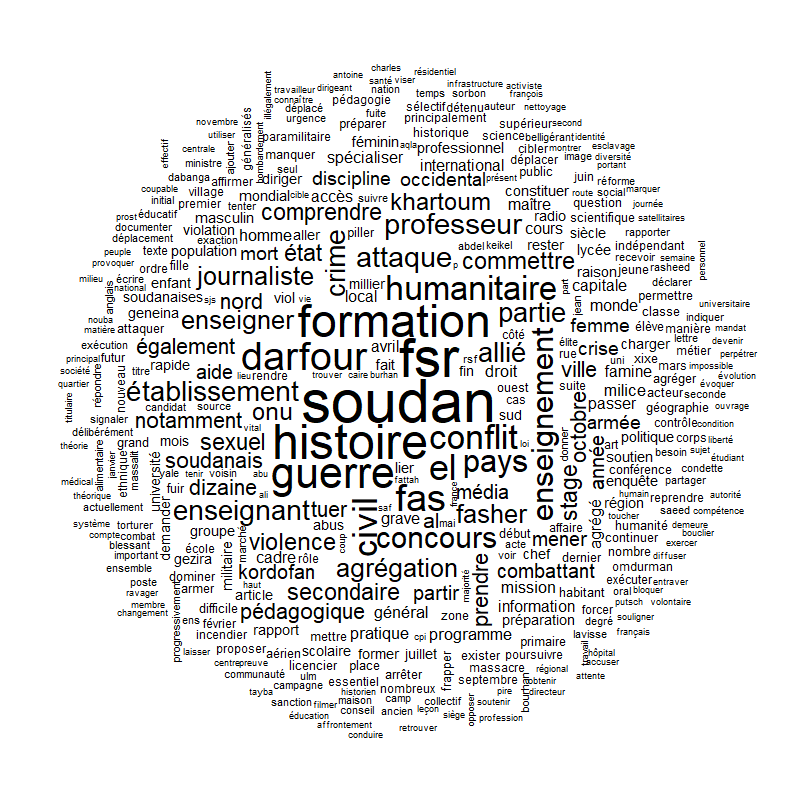
- Les termes les plus fréquents sont « Soudan », « guerre », « FSR », « Darfour », « humanitaire » et « conflit ».
- Le vocabulaire met l'accent sur les acteurs armés et sur les conséquences pour les civils.